每日复盘|2026-09-14
今天是9月14日,星期一。
英语课,没有太多要说的,今天是表演一个drama。
我们选的名字叫“I know what you did last night”,本质是五个人讨论昨天晚上做了什么。
仓促准备一下,上台表演之后就完事了。
接下来是比较有趣的一个内容。
上课的时候,我想,读论文对我来说有点煎熬。一方面,基本上所有论文都是用英语写作的,我不容易理解;另一方面,即使翻译成中文,然后用各种AI解读,我还是难以对正片论文发生了什么有比较明确的认知。
所以,我想做一个产品,帮助我读论文。最开始,我想的是通过OCR工具,将PDF格式的论文提取为markdown格式,在得到markdown之后,就很方便整理。所以,在我们从原始的论文转化为现在的格式之后,我的各种操作就会变得更容易一些。
但是,这样并没有很好解决我遇到的问题:阅读论文对我来说很痛苦,而翻译成中文,然后使用AI解读会改变论文原来的味道。
在我和室友讨论这个问题时,他说,为什么不能让刷论文和刷抖音一样呢?
这个点激发出我的一些想象力,为什么看论文不能像刷抖音一样呢?这可以解决我遇见的第一个问题:阅读论文对我来说很痛苦。如果能够让枯燥、干巴巴的论文变得更有趣、更吸引人,那么不是更容易看下去了吗?
然后,我又结合曾经了解到的wiki知识,与ChatGPT讨论,逐渐明确我的需求。
首先,像抖音一样,在首页用钩子吸引住读者,比如说用一个问题。但是,这个问题必须要忠于论文本身,不能成为噱头。
如果用户对这篇论文的知识感兴趣,ta可以选择展开,然后是对论文的深入了解,就像讲故事一样,将读者代入进论文讨论的问题、它的解决方案和效果。最后,用户表现非常感兴趣,那么就可以阅读论文原文。
第二,wiki的使用方式。在观看论文故事时,中间出现的一些关键概念可以做成wiki的形式。这个wiki会指向一个知识卡片,这个知识卡片包含这个概念的介绍、使用这个概念的相关论文。
第三,导航栏的组织方式。我最初打算做四个导航栏,分别是首页、wiki、收藏、我的。首页就是展示推荐论文的页面;wiki展示看过论文中的概念的wiki卡片;收藏就是首页点击收藏论文的管理页面;我的展示个人信息。
这是产品设计文档:
📄 PaperTok:让论文变得值得刷
一句话定位:
一、产品设计初衷
1. 为什么想做这个产品?
对于本科生、研究生以及刚开始接触科研的人来说,阅读论文往往是一件困难的事情。
真正困难的地方并不一定是论文中的数学公式,而是:
- 不知道这篇论文为什么值得看;
- 第一次接触一个研究方向时缺少背景知识;
- 论文使用大量专业术语,阅读门槛很高;
- Abstract 和 Introduction 往往无法让人快速产生兴趣;
- 面对几十甚至上百篇论文,不知道应该先看哪一篇;
- 即使通过 AI 获得论文总结,也容易变成“看完了,但没有真正产生兴趣”。
因此,我们发现一个更基础的问题:
很多人不是不会读论文,而是根本没有产生“我想读这篇论文”的欲望。
传统论文阅读的流程是:
1 | |
这和短视频产品形成了鲜明对比。
短视频的体验是:
1 | |
因此,我们提出一个问题:
能不能让论文也变成一种“可以被刷到”的内容?
二、核心产品理念
PaperTok 并不是要做一个:
“更好的 AI 论文总结器”。
也不是:
“把论文翻译成人话的 PDF 阅读器”。
更准确地说:
PaperTok 希望改变用户接触论文的第一步。
传统方式:
论文 → 阅读 → 理解 → 感兴趣
PaperTok:
有趣的问题 → 好奇 → 发现论文 → 逐层理解 → 感兴趣 → 阅读原论文
也就是说,我们把顺序反过来了。
三、产品定位
1. 核心定位
论文兴趣发现器(Research Discovery Feed)
或者更直观地理解:
TikTok for Research Discovery
产品不是帮助用户“读完所有论文”,而是帮助用户:
在大量论文中发现那些真正值得自己阅读的论文。
2. 产品核心价值
PaperTok 主要解决三个问题:
问题一:不知道看什么
用户面对大量论文时不知道:
“下一篇应该看什么?”
PaperTok 通过 Feed 主动推荐论文。
问题二:论文没有吸引力
传统论文从 Abstract 开始,信息密度高、专业性强。
PaperTok 从:
Research Question / Conflict / Surprise
开始。
例如:
普通论文:
We propose a novel framework for cold-start knowledge tracing…
PaperTok:
“只看一个学生前 3 道题,你能不能猜出他第 4 道题会不会做对?”
用户首先接触的是一个问题,而不是一段 Abstract。
问题三:产生兴趣以后不知道如何深入
用户产生兴趣之后,可以进入:
Paper Story
逐层了解:
1 | |
四、产品的核心设计
PaperTok 可以理解为三个核心模块:
1 | |
五、模块一:Paper Feed
1. 产品目标
Paper Feed 是用户进入产品后看到的第一个页面。
它不是传统的论文搜索页面,而是一个类似短视频的信息流。
用户不需要提前知道:
“我今天应该研究什么。”
而是直接:
刷一刷今天有什么有趣的研究。
2. 单个 Feed Card
每篇论文首先不是展示标题和 Abstract,而是展示一个:
Research Hook
例如:
🤔 AI真的能从3道题判断一个学生的能力吗?
下面:
Cold-start Knowledge Tracing
以及一个极短的背景:
新学生刚进入学习系统时,模型几乎不了解他的能力。
这篇论文尝试让模型通过少量交互快速认识一个新学生。
用户可以:
- ↑ 继续浏览
- ↓ 返回
- 点击进入 Paper Story
- 收藏
- 跳过
六、Research Hook:产品最核心的内容形式
PaperTok 与传统论文工具最大的差异,很可能就在这里。
我们不直接展示:
Title + Authors + Abstract
而是寻找论文中的:
- Research Question
- Contradiction
- Surprise
- Interesting Finding
- Counter-intuitive Result
- Real-world Problem
然后将它转化为一个用户容易理解的问题。
例如:
原论文
A model for improving cold-start knowledge tracing.
PaperTok Hook
“如果一个学生只答过3道题,AI真的能知道他擅长什么吗?”
原论文
A study on hallucination in large language models.
PaperTok Hook
“为什么 AI 越聪明,有时候反而越容易一本正经地胡说八道?”
原论文
A computer vision paper.
PaperTok Hook
“如果把图片里的所有颜色都去掉,AI还能认出这是什么吗?”
Hook 的目的不是标题党。
而是:
把论文中的科研问题转化成值得思考的问题。
七、模块二:Paper Story
当用户被 Hook 吸引之后,进入论文的核心内容。
这里不直接展示 PDF,也不首先展示 AI Summary。
而是将论文重新组织成一个:
Research Story
Story 的基本结构
Card 1:问题
我们到底想解决什么?
Card 2:为什么重要?
如果不解决这个问题,会发生什么?
Card 3:过去怎么解决?
Previous Work
Card 4:过去的方法有什么问题?
The Gap
Card 5:作者想到了什么?
Key Idea
Card 6:这个 Idea 怎么实现?
Method
Card 7:真的有效吗?
Experiment
Card 8:还有什么问题?
Limitation
最终形成:
1 | |
这实际上就是把论文从:
Academic Paper
转换成:
Research Story
八、模块三:Paper Wiki
Paper Story 解决:
“这篇论文发生了什么?”
Paper Wiki 解决:
“这篇论文涉及了哪些知识?”
例如用户在阅读 Cold-start KT 时遇到:
Knowledge Tracing
点击后进入:
Knowledge Tracing
简单来说:
然后:
相关概念
- DKT
- AKT
- SAKT
- Knowledge State
- Student Modeling
相关论文
- Paper A
- Paper B
- Paper C
本文中的作用
本论文使用 Knowledge Tracing 作为……
Wiki 的核心特点
Wiki 不应该成为一个新的百科网站。
它应该服务于:
当前这篇论文的理解。
因此用户看到的所有知识都应该回答:
“这个东西为什么出现在这篇论文里?”
九、逐层理解机制
PaperTok 不应该一次性把所有信息展示给用户。
而是:
Layer 1:兴趣
这篇论文为什么有意思?
Layer 2:直觉
它到底在解决什么问题?
Layer 3:方法
作者到底怎么做?
Layer 4:专业细节
公式、模型结构、实验设计。
Layer 5:原论文
回到证据。
形成:
1 | |
这就是产品最核心的“渐进式理解”。
十、为什么不是“AI总结论文”?
这是产品定位中必须明确的一点。
传统 AI Paper Assistant:
Paper → Summary
PaperTok:
Paper → Story → Curiosity → Exploration
传统 AI 的目标:
提高阅读效率。
PaperTok 的目标:
提高阅读意愿。
两者是不同的问题。
十一、AI 在产品中的角色
AI 不应该成为产品的主角。
用户不应该不断看到:
“Ask AI”
“AI Summary”
“AI Explain”
而应该看到:
一个自然的研究故事。
AI 在后台负责:
1 | |
即:
Invisible AI
AI 是生产内容的基础设施,而不是产品体验本身。
十二、产品与现有竞品的区别
目前主流产品大致可以分为:
产品类型代表产品核心目标论文搜索Semantic Scholar找论文文献调研Elicit找相关研究论文问答SciSpace读懂论文难句解释Explainpaper解释难点论文总结Scholarcy快速总结文献关系ResearchRabbit探索论文关系研究证据Consensus找研究结论
PaperTok 不试图替代这些产品。
它的定位是:
论文发现 + 兴趣激发
核心问题:
“为什么我要读这篇论文?”
十三、MVP
第一版应该非常小。
不做:
- ❌ 完整论文数据库
- ❌ 复杂推荐算法
- ❌ Zotero
- ❌ 文献管理
- ❌ AI Chat
- ❌ 多论文比较
- ❌ Systematic Review
- ❌ 复杂知识图谱
- ❌ 在线 PDF 编辑
- ❌ 写论文助手
只做四件事情:
1. Paper Feed
上下滑浏览论文。
2. Research Hook
每篇论文生成一个吸引人的科研问题。
3. Paper Story
5~8张 Card 逐层讲清楚论文。
4. Original Paper
最后链接到原论文。
十四、最小产品流程
1 | |
整个体验的目标是:
让用户从“刷到论文”自然过渡到“主动想读论文”。
十五、MVP 的关键验证指标
第一阶段不需要关注:
DAU、商业化、广告、订阅收入。
首先验证:
指标一:Hook → 点击率
用户看到 Hook 后:
有多少人愿意点进去?
指标二:Story 完读率
进入 Paper Story 后:
有多少人愿意看到最后?
指标三:Original Paper 点击率
最重要的指标之一:
有多少人最终愿意打开原论文?
因为这证明:
PaperTok 并没有把用户留在 AI 总结里,而是真正激发了科研兴趣。
指标四:下一篇继续率
用户看完一篇:
是否愿意继续刷下一篇?
这决定产品是否真正拥有“Feed”属性。
十六、产品成功的标准
PaperTok 并不是让用户说:
“这个 AI 总结得真好。”
真正理想的用户反馈应该是:
“我本来根本没想看这篇论文,但是这个问题好有意思。”
或者:
“等等,这个方法为什么有效?我想看看原论文。”
甚至:
“还有没有类似的论文?”
如果用户产生了这些反应,说明产品真正完成了它的使命。
十七、产品愿景
短视频改变了人们发现娱乐内容的方式。
Wikipedia 改变了人们探索知识的方式。
PaperTok 希望结合两者:
用短视频的信息流降低科研知识的发现门槛,用 Wiki 式结构降低论文的理解门槛。
最终形成:
1 | |
最终我们希望实现的不是:
“让论文变得简单。”
而是:
“让人愿意主动靠近论文。”
十八、当前产品原则
Principle 1:兴趣优先于效率
我们不是首先追求:
“一分钟读完一篇论文。”
而是追求:
“一分钟后,你想继续看。”
Principle 2:故事优先于总结
不要简单压缩论文。
应该重新发现论文中的:
问题、冲突、发现、惊喜。
Principle 3:渐进式理解
不要一次把所有知识塞给用户。
让用户:
想知道 → 再告诉他。
Principle 4:AI 隐身
用户不需要知道背后用了多少 AI。
最终体验应该像:
有人把科研故事讲给我听。
Principle 5:始终可以回到原文
所有重要内容都应该能够追溯到:
论文原文。
PaperTok 可以降低论文门槛,但不能脱离论文证据。
十九、第一阶段产品假设
目前我们最需要验证的并不是:
“技术能不能实现?”
而是:
“论文是否真的可以通过 Hook + Story 的方式变得更有吸引力?”
因此第一阶段应该采用:
Content-first MVP
先人工选择论文、人工辅助设计 Hook,再用 AI 生成部分内容。
如果用户愿意:
刷 → 点击 → 看完 → 打开原论文 → 继续刷
那么再投入时间开发完整的自动化 Pipeline。
二十、最终产品概念
PaperTok
让论文变得值得刷。
Feed 负责让你发现论文。
Hook 负责让你产生好奇。
Story 负责让你逐层理解。
Wiki 负责让你继续探索。
原论文负责提供最终证据。
我们不希望用户因为:
“老师让我看论文。”
而打开 PaperTok。
我们希望有一天用户会因为:
“今天有什么有意思的研究?”
而打开它。
今天晚上做了一会,我对AI生成demo的效果还是比较满意的。
后续的问题是:
1、wiki的组织方式和阅读方式
如果多篇论文指向同一个wiki页面,wiki页面怎么呈现
如果从首页直接点进wiki界面,我认为是不是按照wiki界面的浏览顺序去呈现出调整。
所以,我觉得wiki的编排就有三种组织形式,分别对应:当前论文、相关论文、直接点击。
在一个wiki中,有当前论文(正在看的论文)、相关论文(使用同一个wiki的论文)。
直接点击wiki,展示的是结构化的wiki,只有“按领域探索”一种方式。
只有用户打开原论文之后,wiki自动加入。
2、论文展开逻辑
首页点击“展开”后,第一页应该展示什么?
3、工具的盈利模式
4、工具是否值得使用
然后是这两天看的《如何阅读一本书》的总结。
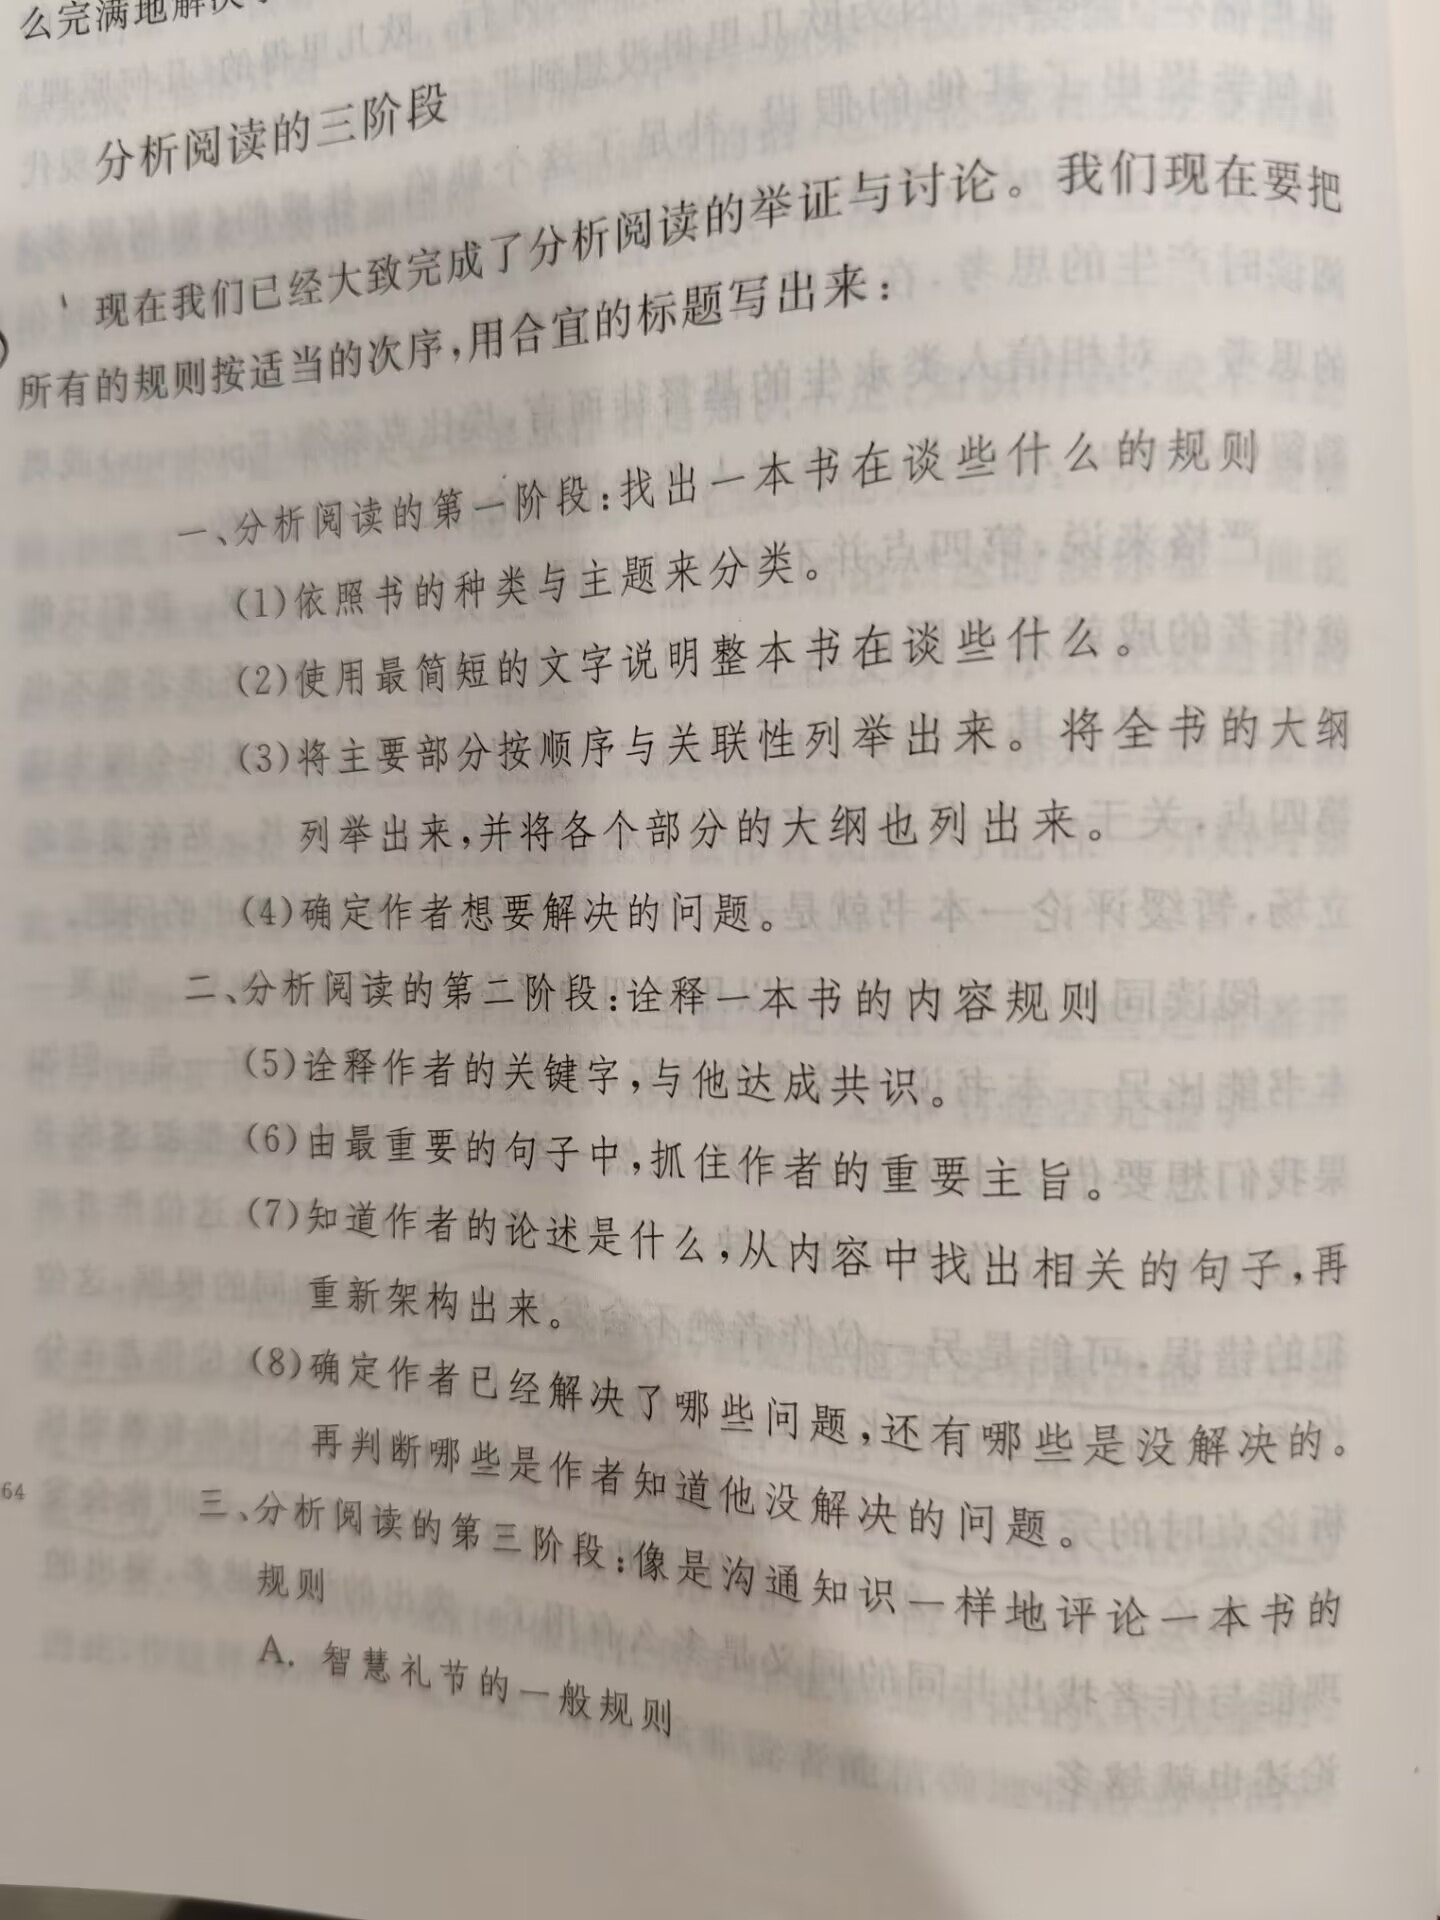
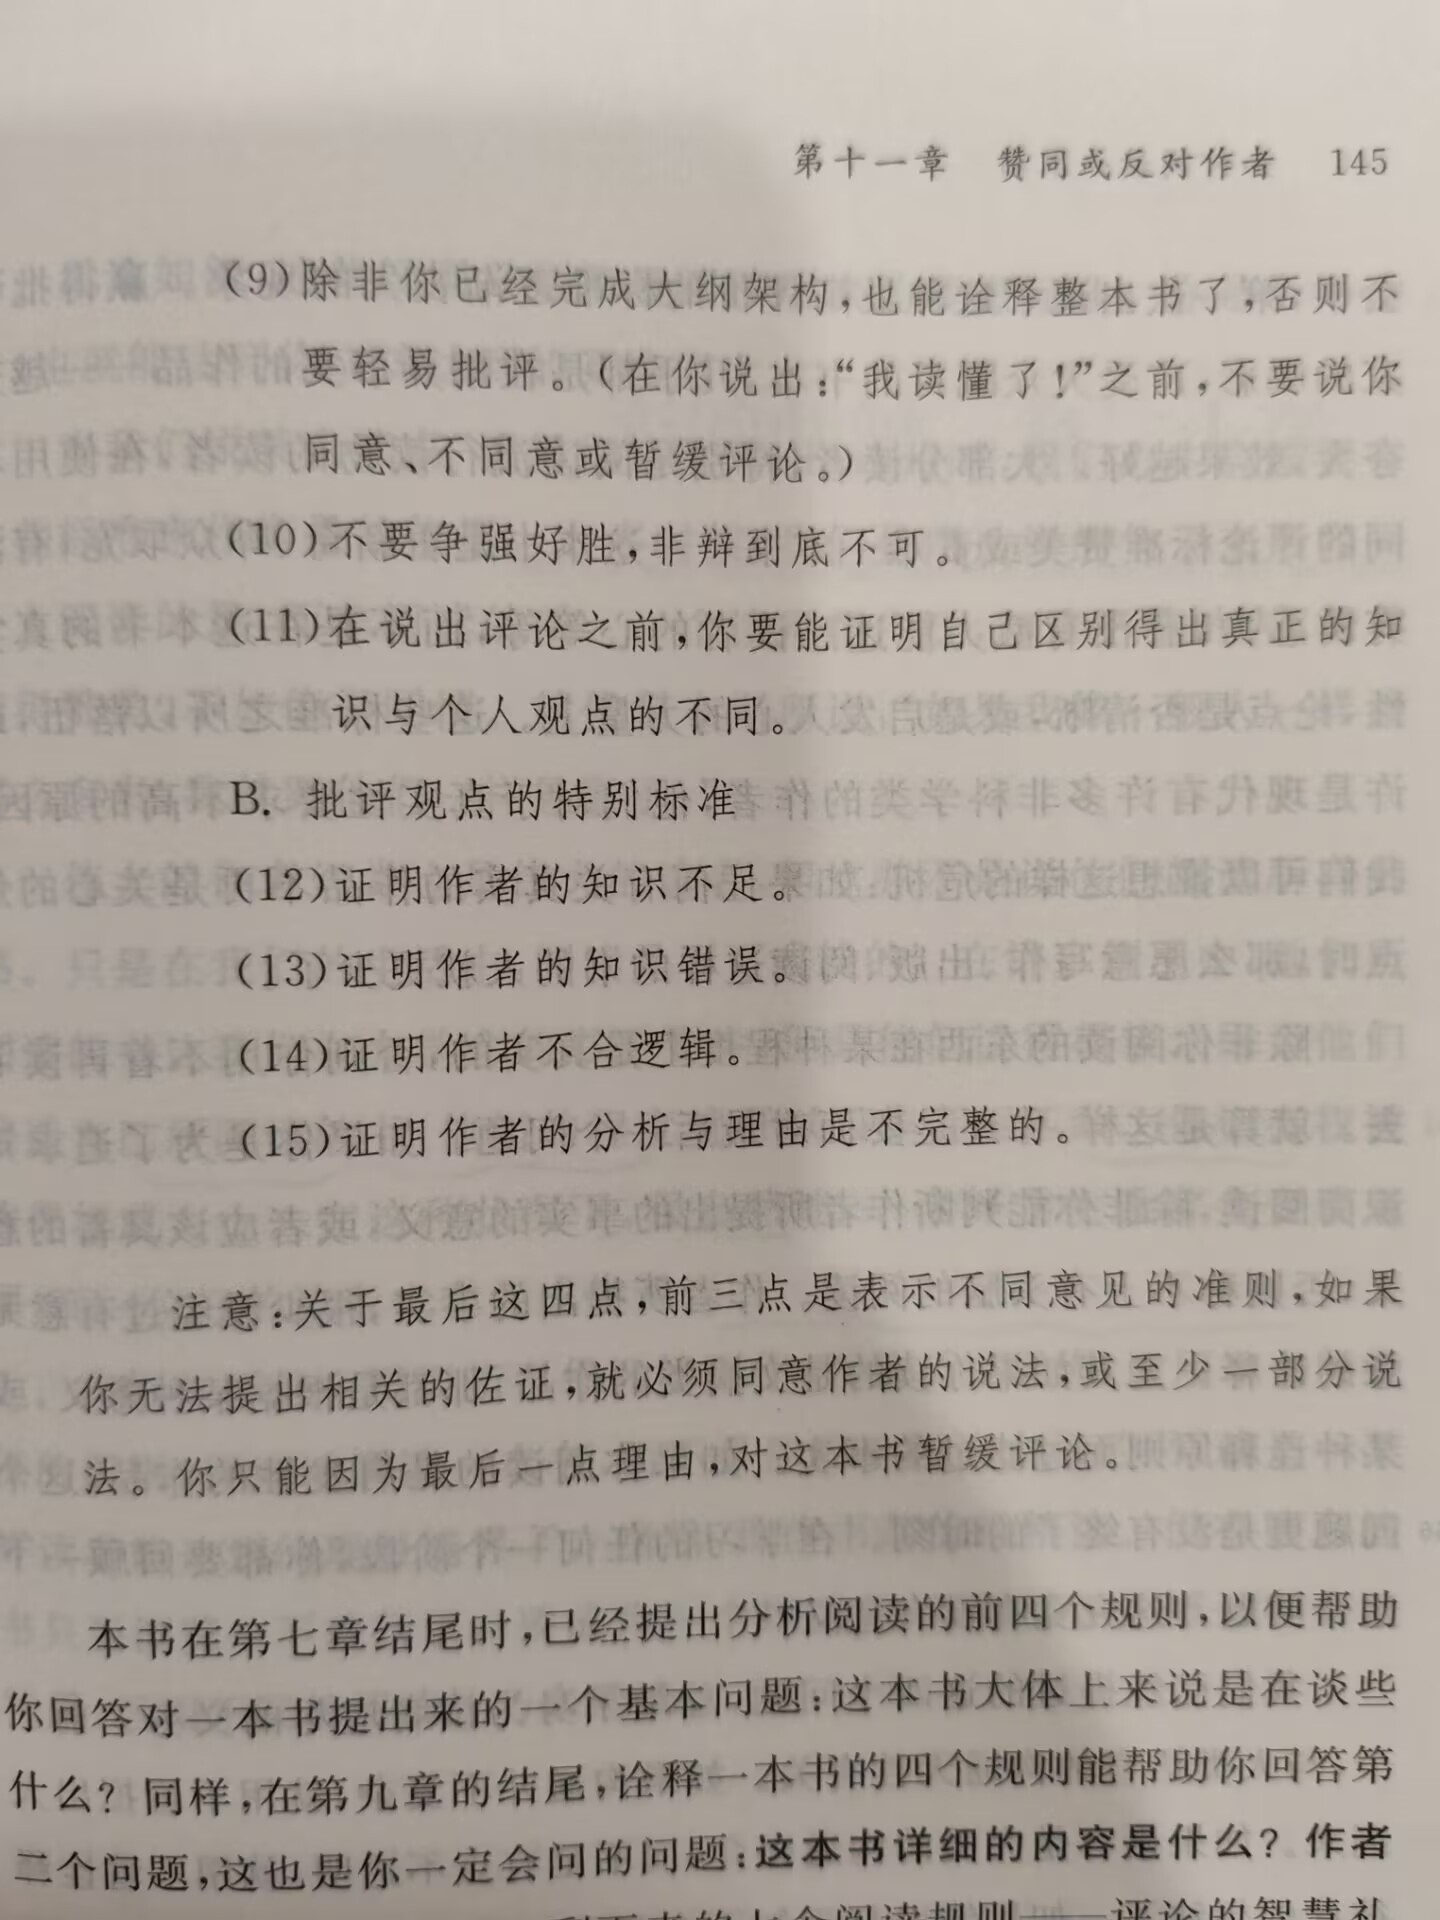
然后是阅读不同类型读物的方法。
如何阅读一本实用的书。
任何实用性的书都不能解决该书所关心的实际问题,实际的问题只能靠实际来解决。
如何阅读想象文学。
首先要代入想象文学,不要抗拒想象文学带给你的影响力。
在想象文学中,不要去找共识、主旨和论述。
不要用适用于传递知识的,与真理一致的标准来批评小说。